Una parte de lo que parecía incomprensible dentro de la inteligencia artificial (IA) podría tener una lógica que los investigadores habían pasado por alto. Esa es la propuesta de Nick Cammarata, investigador de Goodfire y antes de OpenAI, en el ensayo que publicó el 15 de octubre de 2026.
La pregunta tiene consecuencias prácticas. Cuando un chatbot inventa un dato, necesitamos averiguar qué produjo el error para poder corregirlo. La investigación que intenta reconstruir esos mecanismos se conoce como interpretabilidad mecanicista: estudiar las piezas internas de un modelo y comprobar cómo intervienen en una respuesta.
Por qué hablamos de una caja negra
Los desarrolladores conocen el código y las operaciones matemáticas de una red neuronal. Pero el sistema aprende ajustando sus conexiones a partir de ejemplos: nadie escribe a mano una regla para cada respuesta que dará después. El resultado puede funcionar sin que tengamos una explicación comprensible de cómo llegó a una decisión concreta.
Las «neuronas» artificiales son unidades de cálculo. Reciben señales, las transforman y transmiten información a otras unidades. Se puede medir cuándo se activan y con qué intensidad. La dificultad aparece al intentar traducir esos números a una explicación: qué reconoce cada pieza y cómo la utiliza el resto del modelo.
Qué tienen en común un gato y un auto
Un ejemplo clásico parecía ilustrar ese desorden. En el modelo de visión InceptionV1, una misma neurona respondía a caras de animales y carrocerías de autos. El trabajo Feature Visualization, de Chris Olah, Alexander Mordvintsev y Ludwig Schubert, mostraba en 2017 imágenes creadas por optimización para estimular esa unidad.
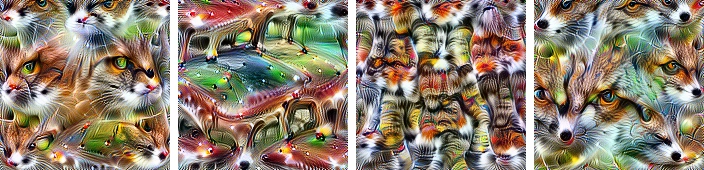
Cammarata propone que esa unidad detectaría rasgos puntiagudos, como una V, presentes en objetos distintos. Un gato y un auto pertenecen a categorías diferentes para nosotros, pero podrían compartir el rasgo visual al que responde esa neurona. Esa interpretación concreta está en discusión.
Su hipótesis es que muchas mezclas aparentemente arbitrarias tienen una estructura que podemos investigar. También plantea que ciertas asociaciones se ramifican durante el aprendizaje: una unidad empieza reconociendo las letras «iy», luego responde a «DIY», sigla inglesa de «do it yourself» («hazlo tú mismo»), y después a la expresión completa. La asociación crece aunque desaparezca la combinación de letras original.
En su ensayo, Neural Networks Are Already Clean, «clean» alude a mecanismos legibles. Cammarata propone estudiar directamente las neuronas y sus conexiones, sin asumir que primero debemos deshacer una mezcla incomprensible. Presenta la idea como hipótesis de trabajo y anuncia un artículo técnico complementario.
Cómo se pasa de reconocer una pieza a explicar una respuesta
Imaginemos que observamos un dispositivo con cientos de indicadores. Saber que uno se enciende al detectar una curva ayuda a identificar una pieza. Para explicar el resultado del dispositivo, también necesitamos averiguar qué recibe esa señal, qué hace con ella y qué cambia cuando la interrumpimos.
Ese recorrido permite buscar una causa. Si al modificar una señal cambia la respuesta de la manera prevista, tenemos una prueba a favor de la explicación. Si el efecto no aparece, hay que revisarla. El objetivo es predecir qué hará el sistema al intervenir sus mecanismos.
Para un usuario, la promesa sería poder investigar por qué un asistente inventa una referencia, interpreta mal una instrucción o insiste en una respuesta equivocada. Una explicación comprobada podría ayudar a localizar el fallo. Hacerlo de forma fiable en conversaciones completas exige entender cómo cooperan muchas piezas.
Ya hay experimentos que cambian respuestas desde dentro
En mayo de 2024, Anthropic identificó representaciones de conceptos en Claude 3 Sonnet. Al amplificar una asociada al puente Golden Gate, consiguió que el chatbot lo mencionara insistentemente y hasta se describiera como el propio puente. El cambio se produjo al intervenir una señal interna.
Ese experimento utilizaba otro modelo para separar características; no había encontrado una única neurona que contuviera todo el concepto de puente. Sirve como antecedente de lo que se puede hacer al relacionar una representación interna con una conducta.
En marzo de 2025, el equipo estudió circuitos en Claude 3.5 Haiku. En una tarea de poesía encontró indicios de que el modelo elegía posibles palabras para una rima antes de terminar el verso. Modificar esas señales alteraba el texto. El siguiente video oficial muestra ese trabajo anterior al ensayo de Cammarata.
En qué discrepan los otros investigadores
Leo Gao, investigador de OpenAI, respondió al ensayo el 17 de octubre. Acepta que se han descartado demasiado pronto patrones que podían entenderse. Pero señala que reconocer un patrón entre varios ejemplos todavía no prueba que sepamos qué hace la neurona en todos los casos importantes.
Su exigencia es usar la explicación para predecir las activaciones y sustituirlas dentro del modelo. Si el sistema se deteriora mucho, la explicación omitía algo relevante. También hay que estudiar los cálculos entre neuronas para entender la red completa.
Liv Gorton, quien trabaja en seguridad en Anthropic y antes fue investigadora fundadora de Goodfire, publicó sus pruebas el 20 de octubre. La explicación de la V no se comportó como esperaba al dibujar figuras simples y redondearlas. Tampoco encontró la dependencia prevista de detectores de V anteriores.
Su análisis incorpora una aclaración de Cammarata: describir esa neurona mediante una letra simplificaba su argumento y planeaba publicar más estudios. Gorton también cuestiona su uso de «superposición», el mecanismo por el que una red reparte y comparte espacio entre representaciones. Que dos conceptos estén relacionados no basta, según su crítica, para descartar que exista ese reparto.
Qué cambiaría si la hipótesis se sostiene
La consecuencia práctica sería disponer de mejores puntos de partida para investigar el modelo: piezas con funciones reconocibles, conexiones que seguir y explicaciones que probar. La discusión está en cuánto de ese mapa puede reconstruirse y con qué precisión. Las objeciones de Gao y Gorton identifican pruebas concretas para evaluar esa promesa.
Anthropic reconocía en su estudio de 2025 que sus herramientas solo capturaban parte del cálculo y que analizar instrucciones cortas requería horas de trabajo humano. Además, observó casos en que el razonamiento escrito por el chatbot no reflejaba el proceso interno. Pedirle a una IA que explique su respuesta no equivale a observar cómo la produjo.
La propuesta de Cammarata merece atención porque ofrece una ruta para investigar esa diferencia. Su valor se decidirá al comprobar si las explicaciones permiten anticipar y modificar el comportamiento del sistema. Comprender mejor sus mecanismos puede ayudar a corregir errores; garantizar su fiabilidad exigirá demostrarlo en las tareas para las que queremos usarlo.